 SEO無料相談
 無料サイト診断
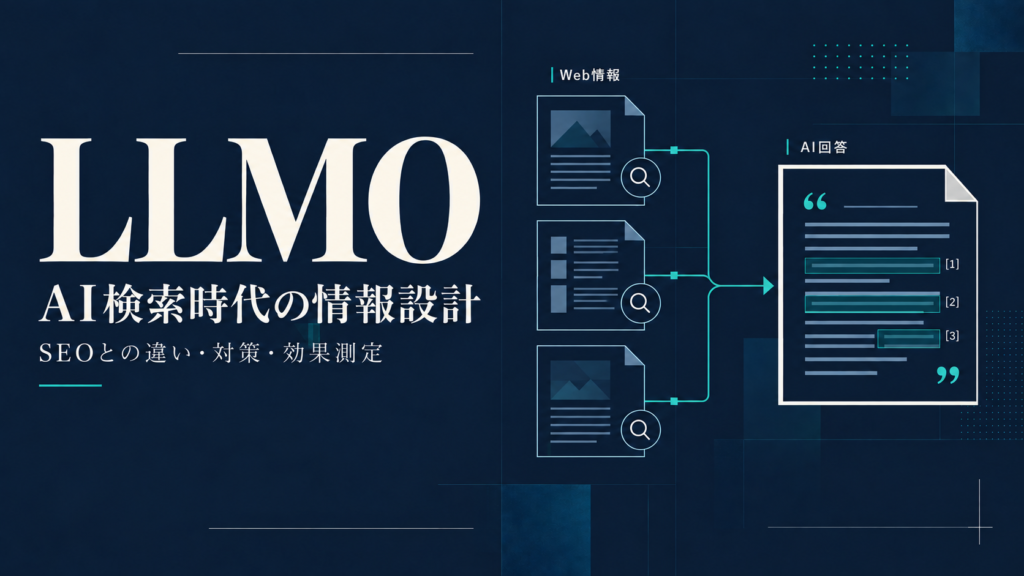
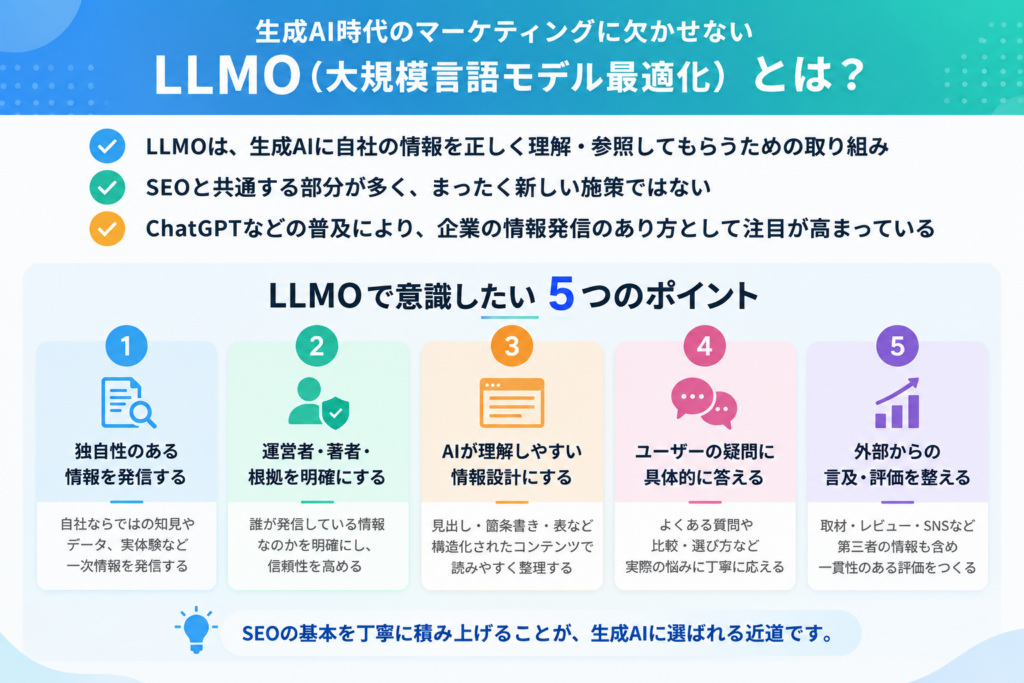
近年、企業のWeb担当者やマーケターの間で、「LLMO」や「LLMO対策」という言葉を耳にする機会が増えています。LLMOとは、Large Language Model Optimization(大規模言語モデル最適化)の略です。生成AIの回答で自社の情報やブランドが正確に紹介・引用されるよう、Web上の情報とその伝え方を整える取り組みです。生成AIを通じた商品やサービスの情報収集に対応するため、従来のSEOとあわせて検討する企業が出てきています。
ただし、LLMOは現時点で国際的に統一された正式な規格名称ではなく、AI検索の最適化を表す呼称としては、GEO(Generative Engine Optimization:生成エンジン最適化)・AEO(Answer Engine Optimization:回答エンジン最適化)・AIO(AI Optimization:AI最適化)など、複数の言葉が使われています。このように新しい用語が次々と登場していますが、生成AIに自社を表示させるためだけの、まったく新しい特別な施策が存在するわけではない、というのがランクエストの見解です(※2026年9月時点)。
生成AIの利用が広がるにつれ、企業にとっては従来の検索順位だけでなく、「AIの回答の中で自社がどのように扱われているか」も新たな確認ポイントになりつつあります。実際に、「ChatGPTなどで自社名やサービス名が出てこない」「競合は紹介されているのに自社は候補に入っていない」「自社サイトを情報源として引用してもらうには何を改善すればよいのか」といった疑問を持つ企業も少なくありません。
本記事では、こうした課題を考えるうえで使われている「LLMO・LLMO対策」という言葉を入り口に、生成AIが情報を取得・参照する仕組みから、企業が実際に取り組める対策までを整理します。具体的には、①サイトの技術環境、②コンテンツの情報設計、③第三者からの評価・情報、④AI上での露出計測と改善という4つの観点を中心に解説します。
単に「AIに表示されること」をゴールにするのではなく、SEOを含めたWebマーケティング全体の中で、生成AIという新しい情報接点にどう対応していくべきかを考えていきましょう。
▼企業が実際に取り組める対策を先に知りたい方は、こちらから。
目次

今すぐ無料で、
あなたのSEO対策費用を
シミュレーション!
簡単な質問に答えるだけで、
最適なSEOプランと費用が無料でわかります。
SEO対策を
行ったことはありますか?

LLMOとは
LLMOを理解するには、「何を整える活動なのか」と「どの状態を成果として見るのか」を分けて考えることが大切です。まず、LLMとの違いと、言及・引用・推奨の基本を確認しましょう。
LLMOの意味と、目指す状態
LLMOは「Large Language Model Optimization」の略で、日本語では「大規模言語モデル最適化」と呼ばれます。ChatGPTやGeminiをはじめとする生成AIサービスの普及に伴い、Webマーケティングの分野でも注目されるようになった考え方です。これらのサービスの基盤となるLLM(大規模言語モデル)や、検索と連携した生成AIが回答を作る際に、自社の商品・サービス・知見が適切に理解・参照される状態を目指す取り組みを指します。
上記のように、生成AIの回答では、企業のWebサイトが情報源として参照・引用されることがあります。ただし、Web上に情報を公開しているだけで、必ず生成AIに取り上げられるわけではありません。
自社の商品・サービスの特徴や料金、実績、利用条件など、ユーザーが判断するために必要な情報を明確に掲載し、AIが取得・理解しやすい状態に整えておくことが重要です。また、公式サイトと外部サイトで情報が食い違っていたり、古い情報が残っていたりすれば、生成AIが自社について正確に回答するための材料が不足する可能性があります。
LLMOでは、単に「AIに自社名を出してもらう」ことだけを目的とするのではなく、自社について正しく理解・参照してもらうための情報をWeb上に整えていくことが基本となります。
LLMとLLMOの違い
LLMは「Large Language Model」の略で、大量のデータを用いて学習した言語モデルです。入力された文章の文脈をもとに、続く語や文字のまとまりを予測しながら、文章生成・要約・質問への回答などを行います。Googleの大規模言語モデルの基礎解説では、この処理に使う単位を「トークン」と説明しています。
LLMが回答を作るためのモデルであるのに対し、LLMOは、そのモデルを利用するサービスで自社情報が適切に扱われるようにする活動です。ChatGPTのような対話サービスには、モデルに加えて検索やファイル参照などの機能が組み合わされるため、サービス全体をLLMそのものと同一視しないほうが整理しやすくなります。
自社サイトのLLMOに取り組むために、独自のLLMを開発・再学習することが前提になるわけではありません。まず取り組むのは、顧客が確認したい情報を公開し、必要なシステムが取得できる状態にすることです。回答のどこに自社情報が使われているかを観測すれば、Web側で改善できる問題と、モデルやサービス側の仕様に依存する問題を分けて考えられます。
LLMの歴史 ― どのように現在の形へ発展したのか
現在のLLMは、突然登場した技術ではありません。文章を扱う「言語モデル」の研究が長年積み重ねられ、ニューラルネットワークやTransformer、事前学習といった技術の発展によって、現在の大規模言語モデルへとつながっています。
特に大きな転換点となったのが、2017年に発表されたTransformerです。文章内の単語同士の関係を効率的に捉えられる仕組みが登場したことで、その後のBERTやGPTなど、現在につながる言語モデルの発展が加速しました。
大まかな流れを整理すると、次のようになります。
| 時期 | 主な技術・モデル | 主な変化 |
| 2000年代 | ニューラル言語モデル | ニューラルネットワークを使って、単語の並びや関係を学習する手法が発展 |
| 2010年代前半 | RNN・LSTMなど | 前後の流れを踏まえて文章を処理する技術が広く活用される |
| 2017年 | Transformer | Attentionを中心とした新しい仕組みが登場し、その後のLLM発展の重要な基盤となる |
| 2018年 | BERT・GPTなど | 大量のテキストを事前に学習し、さまざまな言語処理に活用するモデルが発展 |
| 2020年〜 | GPT-3などの大規模モデル | モデルの大規模化が進み、少ない例や指示からさまざまなタスクを処理する能力が向上 |
| 現在 | 各種LLM・生成AIサービス | 文章生成だけでなく、検索・画像・ファイルなどの機能と組み合わせたサービスが普及 |
この流れを見ると、LLMは単純に「文章を生成するAI」として生まれたのではなく、文章の文脈を捉え、さまざまなタスクを処理する言語モデルが段階的に発展してきたものだと分かります。
LLMの普及で「情報の探し方」も変化している
LLMそのものの進化と同時に注目したいのが、ユーザーと情報との接し方です。
従来のWeb検索では、「SEO対策 方法」「SEO会社 比較」のようにキーワードを入力し、検索結果からWebサイトを選んで情報を確認する行動が中心でした。
一方、生成AIでは「自社に合うSEO対策を教えて」「SEO会社を選ぶときは何を比較すればいい?」といった自然な文章で質問し、回答を得ながら条件を追加して情報を絞り込むことができます。
その結果、企業側では検索順位やWebサイトへの流入だけでなく、「AIの回答で自社が言及されているか」「自社サイトの情報が参照・引用されているか」という新しい接点も確認する必要が出てきました。
こうした生成AI上での情報の扱われ方を意識した取り組みが、一般に「LLMO」と呼ばれているものです。
自社名の言及と、自社ページの引用は異なる
AIの回答内での露出を確認するときは、名前が登場したかだけで判断しないようにします。ブランドへの言及、自社ページの引用、肯定的な推奨は、別々に記録する必要があります。
次の表で、言及・引用・推奨の違いを整理します。
| 確認する状態 | 判定の例 | それだけでは分からないこと |
| ブランド言及 | 説明中に自社のサービス名が登場する | 肯定的に紹介されたか、自社ページが参照されたか |
| 自社ページの引用 | 回答の根拠として自社サイトのURLが付く | ブランドが推奨されたか、リンクがクリックされたか |
| 肯定的な推奨 | 比較検討の質問で、条件に合う選択肢として自社が勧められる | 推奨を読んだ人が購入や問い合わせに至ったか |
たとえば、第三者の比較記事を出典として自社名が紹介された場合、自社への言及はあっても、自社ページの引用があるとは限りません。逆に、自社が公開した用語解説が引用されても、自社サービスの導入を勧められたわけではない場合があります。
紹介内容の正確さも確認しましょう。提供していない機能を「利用できる」と書かれていれば、露出の増加を喜ぶ前に事実との食い違いを調べる必要があります。後半の効果測定では、これらの状態を分けて数える方法を説明します。
LLMOとSEOの違い
LLMOとSEOの違いは、主に「どこで情報が提示され、何を成果として確認するか」にあります。
SEOでは、検索結果から自社ページを見つけてもらい、サイトへの訪問や問い合わせにつなげることを目指します。一方、LLMOでは、生成AIの回答内で自社名や自社情報が正確に扱われ、必要に応じて情報源として引用される状態を目指します。
ただし、両者は完全に分離した施策ではありません。検索と連携する生成AIは、検索インデックスやWebページから取得した情報を回答に利用することがあります。そのため、ページを取得できる状態にすること、読者の疑問へ正確に答えること、情報の根拠を示すことなど、SEOで重視されてきた取り組みはLLMOでも土台となります。
SEOとLLMOを実務上の違いから比較する
| 比較する視点 | SEO | LLMO |
| 情報が提示される主な場所 | GoogleやBingなどの検索結果 | ChatGPT、Gemini、Claudeなどの生成AIによる回答や、Googleの生成AI検索機能 |
| ユーザーとの接点 | 検索結果からページを選び、サイトを訪問する | AIの回答を読み、必要に応じて引用元や公式サイトを確認する |
| 確認する主な状態 | 検索結果での表示、掲載順位、クリック、訪問後の行動 | ブランドへの言及、自社ページの引用、比較候補としての推奨、回答内容の正確さ |
| サイト側で改善するもの | クロール・インデックス、検索意図に合った本文、内部リンク、ページ体験など | SEOの基盤に加え、提供条件、一次情報、引用可能な根拠、外部情報との整合性など |
| 測定指標の例 | 表示回数、掲載順位、クリック率、自然検索流入、CV | 言及率、引用率、推奨率、紹介内容の正確さ、識別可能なAI経由の流入・CV |
| 計測上の注意 | Search Consoleなどで検索結果の数値を継続的に確認できる | 生成AIごとに取得できるデータが異なり、質問や実施条件によって回答も変化する |
LLMOには、SEOの検索順位に相当する統一された順位や共通の測定方法がありません。言及率や引用率を測る場合は、対象とする生成AI、質問文、実施日、検索機能の利用状態、判定基準などをそろえて記録する必要があります。
Googleは、AI OverviewsやAI Modeなどの生成AI検索機能について、従来の検索ランキングや品質システムを基盤としているため、SEOの基本施策は引き続き重要だと説明しています。また、生成AI検索へ掲載されるためだけの特別な構造化データや文章形式は必要ないとしています。
SEOの基本がLLMOでも重要になる理由
AIに取り上げてもらうことだけを目的として、不自然に社名を繰り返したり、質問の言い換えごとにページを量産したりする必要はありません。まずは、顧客が確認したい情報を正確に掲載し、その根拠や適用条件を明確にすることが重要です。
Googleのジョン・ミューラー氏は、2026年5月に公開した公式ブログで、生成AI検索への最適化に関するガイドを紹介しています。その中では、独自性のある有用なコンテンツを提供することや、SEOの基本施策が生成AI検索でも土台になることが示されています。
また、紹介先の公式ガイドでは、Google検索における生成AIへの最適化も、検索体験への最適化であり、引き続きSEOに含まれるという立場が説明されています。GoogleのAI検索に対応する際も、まずは既存のSEO施策と、読者に提供している情報の質を見直すことが出発点になります。
つまり、SEOとLLMOでは観測する場所や指標が異なるものの、読者に役立つ情報を公開し、正確性と信頼性を維持するという土台は共通しています。LLMOはSEOを置き換える施策ではなく、生成AIという新しい情報接点まで確認範囲を広げる取り組みとして捉えるとよいでしょう。
LLMOとAIO・GEO・AEOの違い
LLMOと近い意味で使われる言葉に、AIO・GEO・AEOがあります。違いを理解するには、それぞれの名称が何に着目しているかを見ると整理しやすくなります。
ただし、以下は用語を理解するための整理です。実務では同じ取り組みを異なる名称で呼ぶ場合もあり、各用語に対応する施策が明確に分かれているわけではありません。
| 用語 | 略語の意味 | 名称が着目しているもの | LLMOとの関係 |
| LLMO | Large Language Model Optimization/大規模言語モデル最適化 | LLMを利用したサービスで、自社情報がどう扱われるか | 本記事では、生成AIの回答における自社情報の言及・引用・正確さを改善する取り組みとして扱う |
| AIO | AI Optimization/AI最適化 | AIによる情報の理解や提示 | AIへの最適化を表す名称として、LLMOと近い意味で使われる。対象とするAIや機能の確認が必要 |
| GEO | Generative Engine Optimization/生成エンジン最適化 | 情報を収集・統合して回答を生成する検索・回答システム | 生成された回答内での露出や引用を扱う点で、LLMOと重なる |
| AEO | Answer Engine Optimization/回答エンジン最適化 | ユーザーの質問に直接答えを提示する仕組み | 質問への回答に自社情報を利用してもらう点で、LLMOと重なる |
実際に、Adobeの公式ドキュメントでは、LLM OptimizationとGEO・AEO・AIOを、AIが生成する回答でブランドやコンテンツを見つけてもらうための取り組みを表す呼称として紹介しています。このように、用語を同義に近いものとして扱う発信元もあります。
参考:Adobe「ブランドのAI検索での可視性に関するベストプラクティス」
GEOには研究上の定義もあります。Pranjal Aggarwal氏らの論文「GEO: Generative Engine Optimization」では、生成エンジンの回答内でコンテンツの可視性を高めるための枠組みとして提案されています。研究の対象は回答内で情報がどのように取り上げられるかであり、通常検索の掲載順位とは評価対象が異なります。
参考:Aggarwal氏ら「GEO: Generative Engine Optimization」
たとえば、自社サービスの料金と適用条件を明確にし、AIの回答がその内容を正しく紹介しているか確認する作業は、LLMO・GEO・AEOのいずれの名称で説明されても不自然ではありません。同じ作業を、名称ごとに別々に実施する必要はないでしょう。
施策を検討するときは、用語だけで判断せず、「対象はGoogleのAI検索か、ChatGPTなどの対話サービスか」「自社名の言及を増やしたいのか、ページの引用や説明の正確さを改善したいのか」を具体化すると、必要な作業と測定方法を決めやすくなります。
なぜLLMOが注目されているのか
検索結果に回答が加わり、対話で条件を絞り込めるようになると、企業と顧客が接する場面も変わります。流入数の増減だけでなく、訪問の前にどの情報へ触れているかを考える必要があります。
検索結果に要約・回答が加わっている
GoogleのAI OverviewsやAI Modeのように、検索に生成AIの回答が組み合わされる機能があります。ユーザーは複数のページを開く前に、回答の中で概要、選択肢、注意点を確認できるようになります。
こうしたAI検索は、すでに広い範囲へ展開されています。Googleによると、AI Overviewsは2025年5月時点で200以上の国と地域、40以上の言語で提供され、利用者は15億人を超えています。生成AIによる回答は、一部の新しい検索機能ではなく、多くのユーザーが接する検索体験の一部になりつつあります。
参考:Google「AI Overviews expand to over 200 countries and territories, more than 40 languages」
たとえば、サービス導入の準備を調べる人が、最初の回答で「社内の利用人数」「既存システムとの連携」「移行支援の有無」を比較条件として知る場面が考えられます。この段階で自社に関する情報が紹介されれば、公式サイトへ訪問する前から候補として認識される可能性があります。
自社で確認したいのは、単に名前が載るかだけではありません。顧客がどのような比較軸を知り、どの説明を根拠に候補を絞るのかを見ると、公式サイトで説明すべき情報が明確になります。
ユーザーが対話で条件を絞り込むようになっている
対話型の情報収集では、最初の質問に続けて条件を加えられます。「おすすめの勤怠管理システムは」と聞いたあとに、「店舗が複数ある」「アルバイトの勤務が多い」「給与計算と連携したい」と具体化するような使い方です。
質問の仕方にも変化が見られ、Googleは2025年5月、AI Modeの初期ユーザーについて、従来の検索と比べて2〜3倍の長さのクエリを入力していると説明しています。短いキーワードだけでなく、より具体的な条件や意図を含めて質問する使い方が広がっていることがうかがえます。
参考:Google「AI Mode in Google Search」
このような場面に対応するには、広いテーマの紹介に加えて、条件ごとの判断材料が必要です。「多様な業種に対応」と書くだけでは、どの勤務形態に対応しているのか、追加設定や費用が必要なのかを判断できません。対応できる条件と難しい条件を明らかにしたほうが、顧客の疑問を解決できます。
質問を考える際は、営業商談や問い合わせで実際に聞かれる内容を出発点にしましょう。顧客が意思決定の途中で何を確かめるのかを把握すると、用語解説・比較情報・導入条件のどこを補うべきかが見えてきます。
ゼロクリックと流入経路の変化をどう捉えるか
ゼロクリックとは、検索結果などで情報収集が完結し、外部サイトへのクリックが発生しない状態を指します。生成AIの登場以前からある現象ですが、回答の中で必要な情報を確認できれば、ページを開かずに次の判断へ進む場面も考えられます。
そのため、引用が増えたことと、流入が増えたことは分けて評価します。定義を知りたい質問では回答だけで完結しやすくても、見積もり、詳細な仕様、申込みなどでは公式サイトの確認が必要になる場合があります。自社のページが、情報収集のどの段階を支えているかを踏まえて見ることが重要です。
AIによる回答が表示された場合、実際のクリック行動にも違いが見られるという調査があります。Pew Research Centerが米国の成人900人を対象に2025年3月のGoogle検索行動を分析したところ、AIによる要約が表示された検索では、通常の検索結果がクリックされた割合は8%でした。AIによる要約が表示されなかった検索では15%だったため、AIによる回答が表示される検索では、外部サイトへのクリックが少なくなる傾向が確認されています。なお、AI要約内のリンク自体がクリックされた割合は1%でした。
検索順位ごとのCTRへの影響を調べたデータもあります。Ahrefsが30万キーワードを対象に行った2025年の調査によると、AI Overviewsが表示される情報収集型キーワードでは、表示されない類似キーワードと比較して、検索1位ページのCTRが平均34.5%低いと報告されています。
参考:Ahrefs「AI Overviews Reduce Clicks by 34.5%」
また、自然検索からの流入が減っただけで、原因を生成AIと決めつけることはできません。検索順位の変化、需要の季節性、競合ページ、検索結果の表示、サイトの技術的な問題なども確認が必要です。検索表示・クリック・AI回答内の状態・訪問後の行動をそれぞれ記録し、どこに変化が起きたかを切り分けます。
新しい接点・ブランド認知・運用知見を得る機会
LLMOに取り組む意義は、AI回答からの直接流入だけに限りません。自社を知らなかった人が比較候補として名前を知る、強みや提供条件を理解する、後から社名で検索する、といった接点も考えられます。
ただし、これらは期待できる経路であり、施策を始めれば必ず起こる結果ではありません。認知経路アンケートや指名検索の推移を補助的に確認し、実際の問い合わせ内容と合わせて評価します。回答への露出と事業への貢献をつなぐには、観測できる事実を積み重ねる必要があります。
早い段階から始める価値としては、自社がどのように紹介されるかを記録し、情報の不足や誤りを把握できることも挙げられます。質問の選び方、更新担当、確認手順を整えておけば、サービスの仕様が変わったときにも比較しやすくなります。先行者利益を前提に予算を投じるより、自社で確かめられる課題と学びを明確にして取り組みましょう。
AIが情報を取得し、回答・候補を作る仕組み
AIの回答は、学習済みの知識だけで作られる場合も、検索で得た情報を組み合わせる場合もあります。すべてのサービスに同じ処理手順を当てはめず、どの情報経路を確認しているのかを分けて考えます。
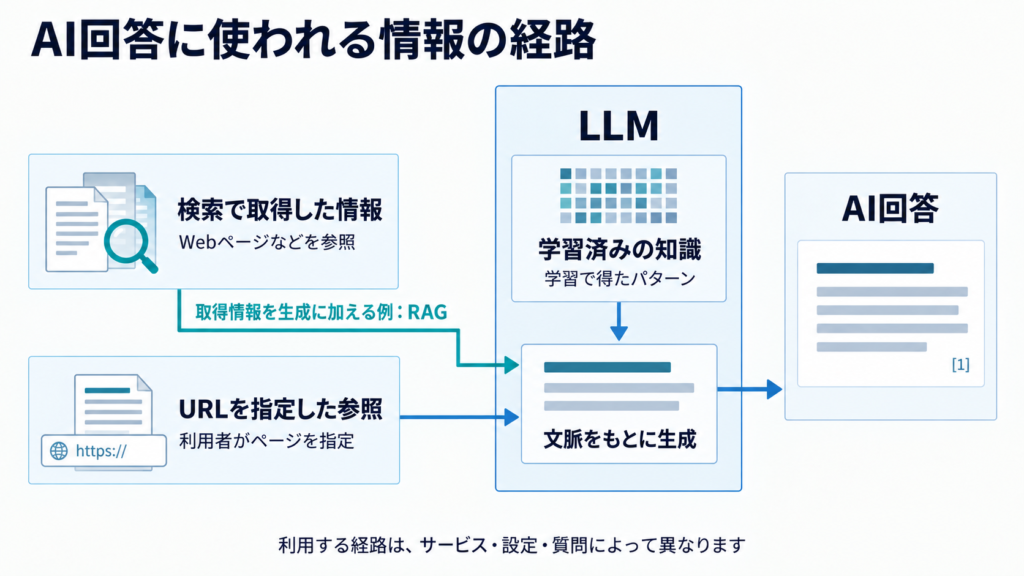
図2:学習済みの知識と、その場で取得する情報は別の経路です。使われる経路はサービス・設定・質問によって異なります。
学習済み知識・検索取得・URL参照の違い
LLMOを考えるうえでは、回答に使われる情報の経路を大きく分けておくと便利です。次の3つは理解のための整理であり、サービス内部の機能を完全に分類したものではありません。
| 情報の経路 | どのような情報を使うか | 自社で考えるべきこと |
| 学習済みの知識 | モデルの学習で得た言語や情報のパターン | 自社サイトを更新しても、モデルの知識がその場で更新されるとは限らない |
| 検索で取得する情報 | 質問に関連して検索システム等から得た情報 | ページの発見・取得、内容の正確さ、引用元を確認する |
| URLを指定して参照する情報 | 利用者が示したページなど、サービスが取得できる情報 | 対象URLを読めるかを確認できるが、一般の質問で自然に発見されるかは別問題 |
たとえば、「このURLにあるサービスの料金を説明して」と依頼して正しく回答されたとしても、「条件に合うサービスを教えて」という質問で同じページが選ばれるとは限りません。URLの直接参照は取得の確認には役立ちますが、検索や比較における露出の確認とは分けて扱います。
検索機能の有無や設定によっても、参照できる情報は変わります。後で回答を比較できるよう、サービス名だけでなく検索機能の利用状態や実施日を記録しておくことが必要です。
LLMが回答を生成する基本とRAG
LLMは、入力された質問や与えられた文脈を踏まえて文章を生成します。文として自然であることと、事実が正しいことは同じではありません。料金、提供地域、利用条件など、変わる可能性がある情報では、回答の根拠と現在の公式情報を照合する必要があります。
検索などで取り出した情報を回答生成の材料に加える仕組みは、RAG(Retrieval-Augmented Generation、検索拡張生成)と呼ばれます。GoogleのAI検索ガイドでは、検索システムから関連するページを取得し、その情報を回答の根拠に利用する方法として説明されています。Google CloudのRAG解説
ここでWebサイト側に求められるのは、判断に必要な情報を取得できる形で提供することです。たとえば、対象プランや適用日が分からない料金だけを示すと、数字が取得されても条件を誤解される余地が残ります。「どの商品・プランについて、いつから、どの条件で適用する情報か」を一緒に示せば、人が確認する際にも意味が明確になります。
なお、RAGを利用すれば誤回答がなくなるわけではなく、すべての質問でWeb検索が実行されるとも限りません。学習済み知識と取得情報をどう使うかは、サービスや機能によって異なります。
Google検索のクエリファンアウトとは
クエリファンアウトは、元の質問に答えるために、関連する複数の検索を並行して行い、追加の情報を集める手法です。Googleは生成AI検索機能の説明で、この方法を紹介しています。
たとえば、「複数店舗で使う勤怠管理システムを選びたい」という質問には、打刻方法、店舗間の管理権限、シフトへの対応、給与計算との連携など、複数の調査観点が含まれます。これは仕組みを理解するための想定例であり、Googleが実際にその検索を行った記録ではありません。
記事を作る際は、こうした関連する疑問のうち、読者の判断に必要なものを整理します。ただし、想定できる質問の言い換えごとに別ページを量産する必要はありません。同じ答えになる疑問は統合し、異なる条件や選択肢は必要な説明を残すと、内容の重複を抑えながら判断材料を揃えられます。
クエリファンアウトはGoogleのAI検索を理解するための説明であり、全LLMに共通する固定仕様ではありません。 また、関連する疑問を扱うことと、AIが内部で実行する検索を正確に予測できることも別です。
AIが参照する情報源と、候補を調べる際の観点
自社についての回答を調べると、公式サイトのほかに、比較記事、専門媒体、利用者のレビューなどが根拠として表示される場合があります。自社ページだけを直しても外部の古い説明が残ることがあるため、実際に表示された引用元を開いて確認することが大切です。
情報源には、それぞれ確認しやすい内容があります。たとえば、仕様や契約条件は公式情報、他製品との比較軸は比較記事、実際の利用場面は利用者の経験が参考になります。どの種類の情報なら常にAIが優先する、と一律に決めつけず、質問と回答の関係から調べましょう。
候補として挙がった企業を調べる際は、次の点を記録すると改善につなげやすくなります。
- どの条件を満たす選択肢として紹介されているか
- その説明を裏付ける引用元があるか
- 引用元には、実績・仕様・比較条件など何が書かれているか
- 自社にも該当する事実があるのに、公開情報が不足していないか
- 公式情報と回答の内容が一致しているか
ここで分かるのは、観測した回答の説明と根拠です。AI内部の評価基準や、採用されなかった理由のすべてが分かるわけではありません。競合の表現をそのまま移すのではなく、自社にある事実と不足している説明を区別して、次の改善課題を決めます。
自社のLLMO対策を進める手順
LLMO対策は、顧客が知りたいことと、自社が正確に答えられる情報を結び付けるところから始めます。回答の記録、不足情報の整理、ページの改善、再確認という順に進めると、施策を選んだ理由を振り返れます。
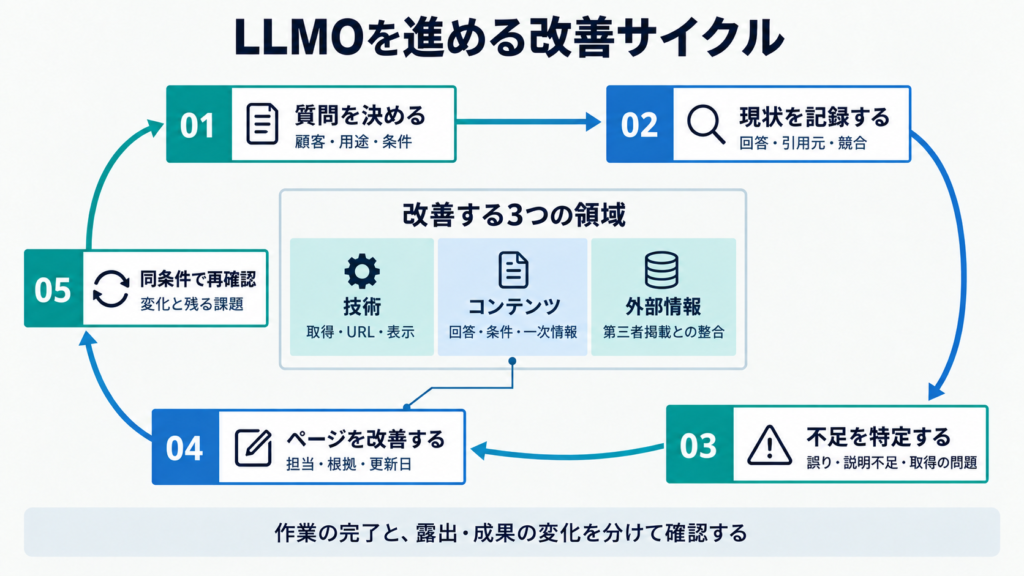
図3:質問と現状の記録を起点に、技術・コンテンツ・外部情報の課題を改善し、同じ条件で確認します。
対象顧客と、確認する質問を決める
まず、誰が、どのような場面で、自社の商品やサービスを検討するのかを具体化します。営業への問い合わせ、商談での比較、サポートへの質問などから、実際の判断に関わる疑問を集めましょう。「サービス名を教えて」という広い問いだけでなく、用途・条件・懸念を含めると、必要な情報を整理しやすくなります。
たとえば、勤怠管理サービスを検討する企業を想定するなら、「勤怠管理システムとは」という基礎的な質問と、「複数店舗のシフト勤務に対応し、給与計算と連携できるサービスは」という比較の質問では、求められる答えが異なります。前者には仕組みの説明、後者には対応する勤務形態や連携先、導入条件が必要です。
自社名を含まない比較質問と、自社名を含む確認質問は分けて扱います。 前者では候補に挙がるか、後者では料金や提供範囲を正しく説明されるかを見ます。自社名を入力した質問で名前が出たことを、自然に発見された成果として数えないようにしましょう。
現在の回答・引用元・競合を記録する
改善前の回答を保存し、自社名の有無だけでなく、紹介された内容とリンク先まで確認します。文章中に自社名があっても、自社ページへのリンクがあるとは限りません。自社ドメインへのリンクがある場合も、改善対象の記事なのか、トップページなのかを分けて記録します。
記録には、質問文、利用サービス、実施日時、言語、地域、ログイン状態、検索機能の有無、画面で確認できるモデル名を残します。回答全文と引用URLを保存し、競合がどの条件に合う候補として紹介されたかも添えます。過去の会話の影響を避けるため、新しい会話で確認し、同じ条件で複数回観測します。
一度の回答で自社が出なかったことだけでは、原因を特定できません。回答が変わる場合もあるため、取得エラーと有効な回答を分け、同じ記録方法を続けることが比較の前提になります。割合の計算方法は、後述の効果測定で整理します。
選ばれる条件と不足している情報を整理する
回答に書かれた推薦理由と、引用先で確認できる根拠を照らし合わせます。競合に関する説明に「特定の業種に対応」「既存システムと連携できる」とあるなら、自社にも該当する機能があるのか、その条件を公式ページで確認できるのかを調べます。これは回答から観測した比較軸であり、AI内部の選定基準を解明したという意味ではありません。
不足は、情報が存在しない場合と、情報はあるものの見つけにくい場合に分けると対応を決めやすくなります。次は課題別の対応例です。
| 観測した課題 | 先に確認・改善すること | 改善後に確認すること |
| 自社名が候補に出ない | 顧客の条件に対応する事実と、その根拠を公開しているページを確認する | 同じ比較質問で、自社がどう扱われるかを再観測する |
| 提供していない機能が紹介される | 公式ページの表現、旧仕様、引用先の説明を照合する | 回答とリンク先の条件が一致するかを確かめる |
| 自社名は出るが、根拠のリンクがない | 回答の論点に対応する公開ページがあるかを確認する | 自社ドメインと対象ページの引用を分けて記録する |
| 引用されたページに比較情報が足りない | 対応範囲・対象外・利用条件を、そのページから確認できるようにする | 回答の正確さと、訪問後に必要な情報へ到達できるかを確認する |
競合と同じ表現を増やすことが目的ではありません。自社が対応できない条件なら、その限界を明示します。対応できるのに根拠が公開されていない場合は、仕様や実際の提供条件を確認してから情報を追加します。
改善するページ・担当・再確認日を決める
不足情報を見つけたら、どのページで答えるのが自然かを決めます。商品の対応機能は商品ページ、導入条件はサービスページ、手順の解説は記事というように、情報を必要とする読者の目的に合わせます。一つの記事にすべてを詰め込むよりも、適切なページに根拠を置き、関連する箇所から案内する方が更新責任も明確になります。
作業ごとに「対象URL・修正理由・修正内容・事実確認者・実装担当・公開日・再確認日」を残します。仕様の確認が必要な修正と、リンク切れの解消などすぐに直せる修正を分けると、作業が止まりにくくなります。
優先するのは、読者の判断を妨げる誤りと、重要な情報へ到達できない問題です。 公開後は、まず修正が正しく反映されたかを確認し、その後に回答や訪問状況を観測します。作業の完了と、回答への反映、事業成果は別々に判断します。
技術面の対策:本文を取得・理解できる状態にする
内容が充実していても、対象の検索サービスがページを取得できなければ、その内容を利用する前提が整いません。公開状態・URL・HTML・描画・表示を順に点検し、実際に問題がある箇所を修正します。
robots.txt・noindex・アクセス制限を確認する
公開したいページについて、正常なHTTP応答が返るか、ログインやアクセス制限がないか、robots.txtで取得を禁止していないかを確認します。Googleの技術要件には、Googlebotがアクセスできること、HTTP 200を返すこと、インデックス可能な内容があることなどが挙げられています。ただし、これらを満たすことと、実際にインデックスされていることは別です。Googleの技術要件
noindexは検索への登録を止める指定です。HTMLのmetaタグだけでなく、HTTPヘッダーの指定も点検します。Googleがnoindexを読み取るには、そのページを取得できる必要があるため、robots.txtによる取得禁止と同じ働きとして扱わないようにします。セキュリティ対策のWAFやCDNが、意図せず対象の取得を妨げている場合もあります。noindexの説明
ボットは用途を分けて判断します。 OpenAIでは、検索用のOAI-SearchBotと、学習に使われ得る情報を取得するGPTBotの設定は独立しています。検索で見つけてもらう目的だけで、すべての学習用ボットまで一括許可する必要はありません。GooglebotとGoogle-Extendedも役割が異なり、Google-ExtendedをGoogle検索の順位を制御する指定として扱うことはできません。OpenAIのクローラー、Googleのクローラー
GoogleのAI OverviewsやAI Modeへの掲載を希望する場合は、インデックスされ、スニペットを表示できるページであることが前提です。そのうえで、Search Consoleの「Settings(設定)」にある「Search generative AI」も確認します。既定はIncludeですが、子プロパティが親の設定を継承している場合もあるため、対象プロパティに適用されている状態を見ます。この設定は対象の生成AI検索機能への掲載を制御するもので、通常検索の他の部分の順位を上げる設定ではありません。GoogleのAI機能の要件、Search generative AIの掲載設定
正規URL・内部リンク・情報の更新を整える
同じ内容が複数のURLで公開されている場合は、どれを正式なページとして扱うかを決めます。canonical、リダイレクト、サイト内のリンク先が食い違っていないかを確認し、Search ConsoleのURL検査では、指定したURLとGoogleが選んだ正規URLも照合します。記事を更新するたびに別URLを作る運用は、情報の分散や古い説明の残存につながるため、必要性を検討しましょう。サイトマップも、公開している正規URLと一致し、削除済み・転送済みなど掲載不要のURLが残っていないかを点検します。Googleの正規URL指定、サイトマップの作成・送信
関連情報へのリンクは、読者が次に知りたいことに合わせて置きます。料金の概要から詳細な条件へ、用語の説明から実践手順へ、といった関係が分かる案内にします。リンクは原則として、遷移先を持つ通常のa要素とhref属性で実装し、「こちら」だけでなくリンク先の内容が分かる文章を使います。Googleのリンクのベストプラクティス
設置する場所やリンク先の選び方は、内部リンクの設置方法で詳しく解説しています。
更新時は本文だけでなく、料金表・FAQ・ダウンロード資料など、同じ条件を記載している場所も確認します。古い資料を残す必要がある場合は、対象期間や現行情報への案内を添えます。更新日は、実際に内容を確認・変更した日と整合させ、日付だけを新しくして済ませないことが大切です。
見出し・表・リストを適切なHTMLで伝える
見た目を大きくした文字と、HTMLの見出しは同じではありません。章にはH2、その中の論点にはH3というように、内容の関係を見出しで表します。比較には見出しセルのある表、並列の項目にはリストを使うと、読む人や支援技術にも関係が伝わりやすくなります。
たとえば、対応機能と対象外の機能を横並びにした画像だけでは、文字として条件を確認しにくくなります。本文にも要点を記載するか、HTMLの表として提供しましょう。図に説明文を添える際も、画像内の長文をすべて代替テキストへ押し込むより、読者が画面上で読める本文に説明を置く方が自然です。
Googleは、完全に整ったHTMLだけを理解するわけではありません。特定のタグ配置をAI引用の条件と考えず、見出しと本文の関係、表の比較軸、リストの並列関係が明確かを点検します。重要な内容をテキストで提供するという考え方は、GoogleのAI機能向け案内でも示されています。
JavaScriptの描画後も重要情報を取得できるか確認する
JavaScriptを使っているという理由だけで、ページ全体の作り直しを決める必要はありません。まず、最初に返されるHTMLに本文があるかを確認し、ない場合は描画後に何が表示されるかを調べます。GoogleはJavaScriptを実行しますが、必要なファイルがブロックされていたり、取得時にエラーが出たりすると、内容を処理できない可能性があります。JavaScript SEOの基本
ブラウザで読めることだけを確認して終わらず、GoogleについてはURL検査などで取得した内容を点検します。料金や仕様の表示にクリック・ログイン・特定の操作が必要な場合は、公開情報としてどこまで取得できるかも調べます。他サービスのボットがGoogleと同じように描画できるとは限らないため、必要に応じて対象サービスの公式仕様やアクセスログも確認します。
重要な本文が取得できないと分かった場合に、初期HTMLへ出力する、サーバー側で生成する、公開説明ページを用意するといった修正を検討します。アコーディオン形式も一律に禁止するのではなく、内容の取得状態と読者の使いやすさで判断します。修正後は、画面表示と取得内容の両方を再確認しましょう。
モバイル表示・読み込み速度・操作性を改善する
スマートフォンで本文を読み、表の列や注記が欠けないか、目次から目的の節に移動できるか、問い合わせボタンが内容を隠していないかを確かめます。AIの回答から訪問した人が根拠を確認できなければ、その先の比較や問い合わせにも進みにくくなります。
速度の改善では、画像の形式とサイズ、不要なスクリプト、読み込み時のレイアウトのずれなどを実測から調べます。Search ConsoleのCore Web VitalsやPageSpeed Insightsを使う場合は、実際の利用者に基づくデータと、特定条件で行うテストの数値を区別します。画像ファイルが大きいという情報だけで、ページ全体の表示が遅いと断定しないようにします。
GoogleはCore Web Vitalsをランキングシステムで使用していますが、良いスコアだけで上位表示が保証されるわけではありません。速度を単独のAI引用要因と考えず、読みたい情報を待たずに確認できる状態へ改善することを目的にします。Googleのページエクスペリエンス
構造化データとllms.txtはどう扱うか
構造化データとllms.txtは、役割も、サービス側での扱われ方も異なります。導入の有無だけで判断せず、何を伝える仕組みなのかと、対象サービスが実際に利用するのかを確認します。
構造化データと画面の情報を一致させる
構造化データは、ページで扱っている記事・商品・組織などの情報を、決められた形式で記述するものです。たとえば、記事の著者や公開日、商品の価格などを表せますが、ページの内容と異なる情報をマークアップしてよいわけではありません。Googleのガイドラインでも、表示する内容との整合や正確さが求められています。構造化データのガイドライン
記事の執筆者と監修者が異なる場合は、その役割を先に整理します。画面では監修者として紹介している人物を、実際には執筆していないのに著者として記述するなど、欄ごとに役割が変わらないようにします。組織名、人物名、プロフィールへのリンク、公開日・更新日も照合します。
CMSのテーマとプラグインが別々に構造化データを出力している場合は、両方の内容を確認します。複数あること自体ではなく、同じ記事について異なる情報を示していないかが点検の要点です。実装した種類に対応するテストで構文や必須項目を確かめ、画面の事実との一致は別に確認しましょう。
AI掲載専用のschemaが必要なのか
GoogleのAI検索機能に掲載されるための、特別なschemaは求められていません。 通常の検索で使用する適切な構造化データは整えつつ、AI向けという名目だけで、内容に合わない種類や項目を追加しないようにします。GoogleのAI検索最適化ガイド
構造化データを追加しても、それだけで情報の正確さや専門性が生まれるわけではありません。先に画面で読める説明を整え、実在する情報を対応する項目に記述します。テストでエラーがなくなったことも、検索で特定の表示になることや、AIに引用されることとは区別します。
FAQも同様です。読者の疑問に答えるFAQ本文は役立ちますが、GoogleのFAQリッチリザルトは2026年5月7日以降、表示を終了しています。FAQPageを付ければ検索結果の表示が広がるという古い説明を前提にせず、質問に答える本文そのものの必要性で判断します。Google Searchの更新記録
llms.txtとは何か、Google検索ではどう扱われるか
llms.txtは、サイトの概要や参照してほしいページへの案内を、Markdownというテキスト形式でまとめる提案です。提案元では、AIエージェントがサイトの情報を利用するときの案内として説明されています。すべてのAIサービスが採用している共通の必須標準ではありません。llms.txtの提案
Googleは、Google検索の表示や順位のためにllms.txtを利用しないと明記しています。そのため、GoogleのAI OverviewsやAI Modeへの対策として、本文や取得性の改善より先に設置を必須とする必要はありません。他のツールや業務で利用する場合は、その利用者・サービスの対応状況を別に確認します。
また、llms.txtはrobots.txtのように取得の許否を伝える仕組みでも、サイトマップと同じ目的の仕組みでもありません。非公開情報を保護する機能はないため、認証が必要な資料の内容や社内情報を転記しないようにします。導入を検討する際は、案内を更新し続ける手間に見合う用途があるかを判断しましょう。
導入を検討する場合の書き方・確認事項
llms.txtを利用するツールがあるなど、具体的な用途が決まっている場合は、提案元の現行仕様に沿って作成します。2026年9月時点のv2提案では、H1のサイト名・プロジェクト名だけが必須で、要約や見出しごとのリンク一覧などは任意です。以下は構成を示す架空の例で、リンク先も説明用です。
# サンプルサービス
> サービスの機能、利用条件、サポート情報の案内です。
## 公式情報
– [機能と対応範囲](https://example.com/features/): 対応機能と対象外の条件
– [利用条件](https://example.com/terms/): 利用に必要な条件
生成ツールを使った場合も、出力をそのまま公開せず、リンクが実在するか、説明と遷移先が一致するか、古いページへ誘導していないかを確認します。設置場所と対象範囲は現行提案を確かめ、利用するツールで実際に参照できるかを試します。
FAQや社内の知見を案内する場合は、先に公開可能な情報を選び、読者が確認できる通常のページへ整理します。定義、適用条件、例、注意点、出典をそのページに持たせ、更新担当も決めておけば、llms.txtの用途に限らず情報を管理しやすくなります。ファイルを作ったことを成果とせず、目的に沿って利用されているかを確認します。
コンテンツ面の対策:判断に使える情報を伝える
コンテンツでは、読者が知りたいことに答え、その答えを確かめられる根拠を示します。一般的な説明を増やすだけでなく、自社が責任を持って公開できる事実を、条件や限界とともに伝えることが基本です。
一次情報・実体験・独自データと条件を示す
一次情報には、自社が提供するサービスの仕様、実際に実施した調査、利用や検証から得た記録などがあります。「使いやすい」「効果がある」という評価だけでなく、何を、どのような条件で確かめたのかを示すと、読者が自分の状況に当てはめて判断できます。
調査なら実施時期・対象・件数・質問方法、検証なら使用環境・手順・対象範囲を添えます。成果を示す場合は、比較期間や指標の定義も必要です。都合のよい一例だけを一般的な結果として紹介せず、確認できなかった点や適用できない条件も伝えましょう。
独自情報は、大規模な調査や成功数値に限りません。 実際の問い合わせを匿名化して整理した判断上の注意点や、公開できる検証手順にも価値があります。ただし、まだ行っていない検証を実施済みのように書かず、説明用の例は想定であると明示します。外部の調査を使う場合は、紹介記事だけで済ませず、原典と調査条件を確認します。
E-E-A-Tと著者・運営元・出典を明確にする
E-E-A-Tは、経験・専門性・権威性・信頼性を表す考え方です。Googleは信頼性を中心に位置付けていますが、E-E-A-T自体が一つの独立した順位要因というわけではありません。また、どの内容も四つを同じ強さで示さなければならないという意味でもありません。Googleの有用で信頼できるコンテンツの案内
| 観点 | 読者が確認できる情報の例 |
| Experience:経験 | 実際に試した手順、使用条件、観察した内容 |
| Expertise:専門性 | 執筆・確認を担当した人の専門領域、根拠に基づく説明 |
| Authoritativeness:権威性 | その分野での活動や、関連する第三者からの評価を確かめられる情報 |
| Trustworthiness:信頼性 | 運営元、出典、正確な提供条件、更新・訂正への対応 |
著者名やプロフィールは、誰が説明に責任を持つのかを伝えるために置きます。肩書きだけを加えるのではなく、その記事の内容に関係する経験や専門領域を示します。監修を記載する場合も、実際に確認を受けた範囲と役割に合わせます。
技術仕様や制度など、外部で定められた事実には、該当する公式資料へのリンクを添えます。自社の見解や実務上の提案は、その事実と分けて説明すると、読者が根拠と判断を追いやすくなります。
顧客の問いを網羅し、同じ答えを整理する
網羅性は、似た見出しを増やすことではなく、読者が判断するための疑問を解消できるかで確かめます。サービスを比較する記事なら、対象者、できること、利用条件、費用の考え方、制約、導入手順、選び方などを、想定する読者の状況に合わせて点検します。
「できること」と「対象外」は、どちらも選択に必要な情報です。一方、「導入するメリット」と「導入効果」で同じ利点を繰り返しているなら、答えを一か所にまとめ、別の節では条件や評価方法を説明します。同義語ごとに新しい節を作る必要はありません。
執筆前に「顧客の質問・答えを置く節・必要な根拠」を対応させ、執筆後は質問ごとに答えが見つかるかを読み返します。根拠が不足する問いは、文字数を増やす前に情報を確認します。詳細を別ページで扱う方が自然なら、本文で要点を答えてから、続きが分かるリンクを置きましょう。
結論と根拠を、見出し・定義文・リストで伝える
各節では、見出しで示した問いにまず答え、理由や根拠、適用条件、具体例へ進むと理解しやすくなります。専門語は初めて出る箇所で意味を説明し、「これ」「それ」が何を指すのか曖昧になる場合は、対象の名称を書きます。定義文なら「○○とは、どのような対象・性質・範囲を指すか」を一文で示すと、その後の説明を追いやすくなります。料金や対応範囲など条件が重要な情報は、結論から離れた場所に注意書きを隠さないようにします。
架空の勤怠管理サービスを例に、説明を具体化します。
| 書き換え前 | 書き換え後 |
| 幅広い勤務形態に対応しています。連携もできるので便利です。 | シフト勤務と固定勤務の勤怠を管理できます。給与データはCSVで出力でき、受け取り側の給与ソフトに合わせて項目を設定します。給与ソフトとの自動連携には対応していません。 |
書き換え後は、対象となる機能、利用方法、対象外の条件が分かります。自社の文章でも、抽象的な評価を具体的な仕様に置き換えられるかを確認しましょう。複数商品を同じ軸で比べるなら表、順番がある作業なら番号付きリスト、同列の条件なら箇条書きが向いています。
形式を選ぶ基準は、人が関係を理解しやすいかどうかです。 GoogleはAI検索のために理想的なページ長や、細かい断片への強制的な分割を要求していません。短くすることだけを優先せず、一つの節で必要な結論と条件が分かるまとまりを作ります。
本文で残る疑問をFAQで補う
FAQは、本文を読んでも残る具体的な疑問を補うために使います。問い合わせや商談で繰り返し聞かれる質問から、適用条件、例外、導入前の準備、利用後の変更などを選ぶと、読み手の判断に役立ちます。本文で十分に説明した定義を、FAQで長く繰り返す必要はありません。
たとえば「導入は簡単ですか」という広い質問よりも、「既存のデータを移行する前に何を用意しますか」とした方が、答える範囲が明確になります。回答は最初に要点を示し、必要な条件や手順を添え、詳しい説明がある場合は該当箇所へ案内します。
質問文だけを増やしても、回答に実質がなければ疑問は解消しません。最新の提供条件に合っているか、本文と矛盾していないかを定期的に確認します。FAQの目的は、特定のマークアップを増やすことではなく、読者が次の判断へ進めるようにすることです。
外部評価の対策:第三者情報と公式情報をつなぐ
AIが参照する情報には、公式サイト以外の紹介記事やレビューなども含まれます。自社で発信する内容を整えるとともに、外部では何が語られ、どの情報を根拠に紹介されているかを確かめましょう。
社名・商品名・提供条件の食い違いを直す
同じサービスについて、公式サイトでは新しい名称、比較サイトでは旧名称が使われていると、利用者が別のサービスだと受け取ることがあります。企業名、商品名、所在地、提供範囲、料金に含まれる内容などを一覧にし、公式情報と主要な掲載先を照合します。表記が違っていても意味が正しければ、すべてを一字一句そろえる必要はありません。
訂正が必要なのは、別の企業と混同している、終了したサービスを提供中と紹介しているなど、判断に影響する食い違いです。誤りを見つけたら、正しい情報を確認できる公式ページを用意し、該当箇所と根拠を掲載元へ伝えます。自社で変更できない媒体についても、連絡した日と対応状況を残しておくと、次回の確認につながります。
調査・専門家の知見を、関連する媒体へ届ける
第三者に紹介してもらうためには、その媒体の読者に役立つ材料が必要です。自社が把握する仕様、現場で繰り返し起きる課題、条件を開示した調査などから、記事や解説に使える情報を整理します。「実績が豊富」といった抽象的な宣伝より、何をどの条件で確認したのかが分かる資料のほうが、内容を検討してもらいやすくなります。
届け先は、業界メディア、専門家、関連するコミュニティなど、情報を必要とする人がいる場所から選びます。SNSでも、結論だけを投稿するより、元の調査や解説にたどれる状態にすると根拠を確かめられます。掲載件数を増やすことと、信頼できる紹介が増えることを分けて考えるのがポイントです。Googleも、不自然な言及の獲得をAI検索向けの有効な近道として扱っていません。GoogleのAI検索最適化ガイド
比較・レビュー・第三者コメントを正確に扱う
比較記事やレビューで自社がどのような条件に向くと評価されているかを見ると、顧客が重視する判断軸を把握できます。たとえば「導入時の支援が手厚い」という紹介があれば、公式ページに支援内容、対象となる契約、対応しない範囲が明記されているかを確認します。第三者の評価をそのまま自社の保証へ置き換えず、提供できる事実を説明します。
実際の利用者による批評は、自社に都合が悪いというだけで誤情報にはなりません。事実の誤りと意見を区別し、訂正依頼は根拠のある箇所に絞ります。レビューや推薦を自作したり、関係性を隠して独立した評価に見せたりする方法は避けましょう。Wikipediaなどの百科事典も、宣伝用の投稿先一覧として扱わず、その媒体の目的と編集方針に沿って対応します。
古い紹介や誤情報へ継続して対応する
社名変更や料金改定の後は、公式サイトを更新しても、過去の紹介記事が残る場合があります。変更した項目、現在の根拠となるURL、影響する掲載先を記録し、内容への影響が大きいものから確認します。古い発表を一律に削除するのではなく、当時の情報として残す必要がある場合は、現在の情報へ進める案内を付ける方法もあります。
AIの回答に誤りが出たら、回答全文、質問、日時、引用元を保存します。引用元が自社ページなら説明を見直し、第三者ページならその記載を確かめます。引用元が表示されない回答では、どの情報が原因なのかを断定できません。正しい公式情報を整え、同じ条件で再確認し、誤りが残るかを追うことが現実的な対応です。
LLMOの効果測定とKPI
LLMOでは、AI回答内の露出と、サイトへの訪問、その後の事業成果を分けて測ります。以下では本記事で用いる指標の定義を示します。ツールや支援会社によって定義が異なる場合があるため、数値を比較する前に対象と算式をそろえましょう。
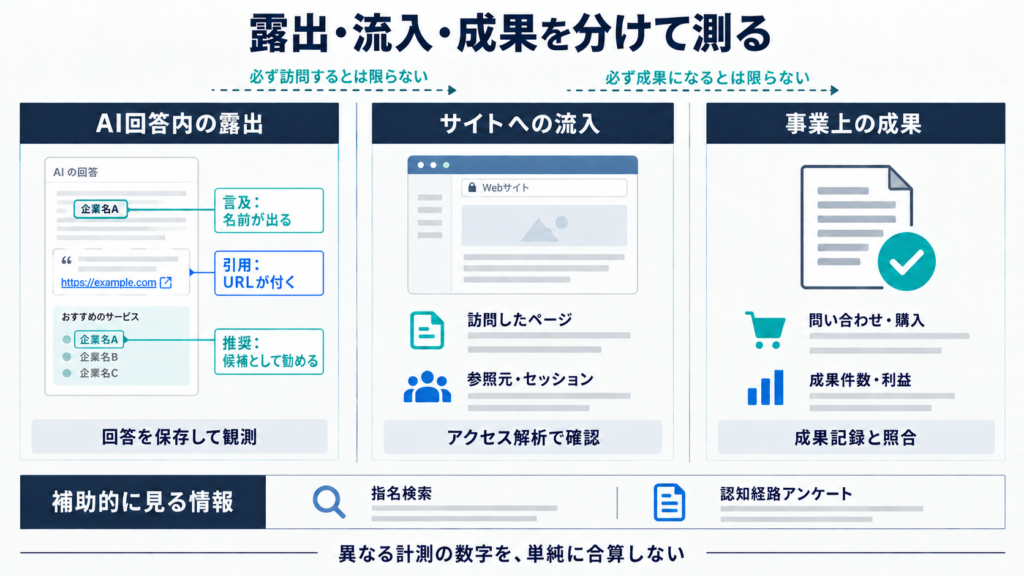
図4:露出・流入・成果は、異なる計測対象です。図内の画面は説明用の模式図で、実測結果ではありません。
ブランド言及・自社ドメイン引用・対象URL引用を分ける
ブランド名が書かれていても、自社サイトへのリンクが付くとは限りません。また、自社ドメインが引用されても、改善した記事とは別のページが使われている場合があります。観測する範囲を次のように分けると、何が変化したかを確かめやすくなります。
| 指標 | 本記事での定義 | 算式 |
| ブランド言及率 | 自社名や対象商品名が登場した回答の割合 | 言及がある回答数÷有効回答数×100 |
| 自社ドメイン引用率 | 対象ドメインのページに参照リンクが付いた回答の割合 | 対象ドメインの引用がある回答数÷有効回答数×100 |
| 対象URL引用率 | 改善対象のページに参照リンクが付いた回答の割合 | 対象URLの引用がある回答数÷有効回答数×100 |
| 推奨率 | 比較検討の質問で自社が肯定的に推奨された回答の割合 | 肯定的推奨がある回答数÷比較検討質問の有効回答数×100 |
同じ回答内で社名が3回出ても、言及がある回答として数えるのは1件です。エラーで回答を取得できなかった試行は有効回答数から除き、失敗件数を別に残します。分母が0なら算出不可とし、0%に置き換えません。これらは選んだ質問セットに対する観測率であり、市場全体での露出割合ではありません。
比較検討質問での推奨と、競合との露出差を測る
「A社とは何か」という指名質問では、自社名が回答に入ること自体が問いの性質に影響されます。支援会社を選ぶ場面を測るなら、業種、目的、予算、必要な支援などの条件を示した比較検討の質問を用意し、その質問群を推奨率の分母にします。情報収集の質問と指名質問は別の群として残すと、結果を解釈しやすくなります。
候補として名前が並んだだけの状態、肯定的な推薦、否定的な紹介は分けて判定します。第一推奨も測る場合は「この条件では最も適している」など、優先する意思が回答に示されたものを対象にし、表示順が先頭というだけでは数えません。その割合の分母も、あらかじめ定めた比較検討質問の有効回答数にそろえます。
同じ回答の中で競合が紹介されていたら、その理由、引用元、条件を記録します。自社より登場回数が多いという結果だけでは改善内容を決められません。「対応業種の説明がない」「比較に使われた情報が古い」といった具体的な不足へ落とし込むことで、観測を施策につなげられます。
AI経由のセッション・訪問先・CVを確認する
アクセス解析では、AIサービス由来と識別できる参照元から、どのページへ訪問し、どのような行動を取ったかを確認します。ChatGPTやPerplexityなどの参照元を確認する際は、実際のレポートに出ている値を基に分類し、対象期間と抽出条件を保存します。参照元が残らない訪問もあるため、識別できた件数をAI由来の訪問全体とは扱いません。
GA4を利用する場合は、トラフィック獲得で「セッションの参照元/メディア」を確認し、ランディングページの情報と組み合わせて入口を調べます。成果として数える行動はキーイベント等で定義し、集計条件を記録します。GA4のトラフィック獲得、ランディングページ
レポートや探索など、画面の役割から確認したい方は、GA4の基本的な使い方も参考にしてください。
セッション数はクリック数と同じではありません。訪問後の問い合わせ、資料請求、購入などは、計測する行動を先に定義したうえで別に集計します。訪問先の閲覧状況やエンゲージメント、関連ページへの移動も見ると、回答から来た人が必要な情報を得られているかを点検できます。
たとえば、AIが導入条件を紹介しているのに、訪問先では条件の記載が見つからないなら、まず情報の場所や説明を直します。アクセスが少ない段階でCV率だけを見て判断せず、訪問数・成果件数と、ページで起きている具体的な問題を併せて確認しましょう。
Google生成AIリンク表示と通常検索の数字を分ける
GoogleのSearch Consoleにある生成AIパフォーマンスレポートでは、AI Overviews・AI Mode内の自社リンクの表示回数を確認できます。集計できる軸はページ、国、日付、デバイスです。クエリごとの内訳や、リンクを伴わないブランド言及、クリック数、CVを示すレポートではありません。Googleの生成AIパフォーマンスレポート
通常の検索パフォーマンスは、検索語、表示回数、クリック、掲載順位などを調べるために使います。一方のレポートで増えた数値を、もう一方の指標の改善と読み替えないことが大切です。アクセス解析でGoogle由来と分かる訪問も、その情報だけでAI回答由来とは特定できません。
通常検索のデータを確認する基本操作は、Search Consoleの機能と使い方で説明しています。
「AI内でリンクが表示された」「実際にサイトへ訪問した」「問い合わせになった」を別々の記録として管理し、対象ページと期間をそろえて評価します。計測手段ごとに対象が違うため、異なるレポートの数字を単純に足し合わせてAI経由の総数を作ることは避けましょう。
指名検索と認知経路アンケートで補う
AIで知った企業名を後から検索したり、ブックマークやURLの直接入力で訪問したりする場合は、AIサービスの参照元だけでは接点を追えません。会社名や商品名を含む指名検索の推移と、問い合わせ時の認知経路を補助的に確認すると、アクセス解析だけでは見えない経路を考えられます。Search Consoleでは、通常の検索パフォーマンスで社名・商品名を含むクエリを絞り、同じ期間・国・デバイス条件で比較します。表記ゆれや他社と同じ名称がある場合は、抽出する語と除外条件も残します。
アンケートでは、たとえば「当社を最初に知ったきっかけ」を任意で尋ね、検索、AIサービス、紹介、広告などの選択肢を用意します。AIを選んだ人にはサービス名や調べた内容を自由に補足してもらう方法もあります。回答者の記憶や回答しない人の存在による偏りがあるため、その件数を接点の全量とは見なしません。
指名検索は広告、広報、展示会などでも変わります。AI向けの改善後に増えたとしても、それだけで因果関係は確定できません。同時期に実施した施策を変更履歴へ残し、時系列や競合との比較も、次に検証する仮説を作る材料として使います。
検証結果を改善につなげる方法
測定を続けるだけでは、情報の不足は解消しません。質問、回答、引用元、変更内容をひと続きに記録し、次にどのページをどう直すかまで決めることで、調査が改善につながります。
同じ質問を複数回観測し、回答を保存する
観測前に、対象サービス、質問文、言語、地域、ログイン状態、検索機能の利用条件を記録します。モデル名が画面に表示される場合はその名称も残し、過去の会話に影響されにくい新しい会話で実行します。温度などの設定は利用環境で確認・調整できる場合に限って記録し、一般の画面で操作できると決めつけません。
同じ質問でも回答が変わるため、実行回数を先に決め、引用された回だけを選ばず全回答を保存します。必要な回数は質問数や運用負担に応じて決め、少数の試行から市場全体の傾向を断定しないことが基本です。サービス側の仕様や条件が変わった場合は、その前後を同じ系列として無条件に比べないよう記録を分けます。
自社と競合の引用元・比較軸・不足情報を分析する
回答に自社が出ていないときは、まず、どのような条件で他社が選ばれているかを読みます。紹介された企業の公式ページや引用元に、その条件を判断できる情報があるかを確かめ、自社の公開情報と比べます。AIが示す理由は観測できる材料ですが、内部の選定要因を完全に説明するものではありません。
以下は、BtoBサービスの比較質問を想定した整理例です。
| 顧客が判断したいこと | 自社で確認する情報 | 不足があった場合の改善 | 改善後に確かめること |
| 自社の業界にも対応できるか | 対象業界、対応条件、確認可能な事例 | 対象・制約・対応内容を具体化する | 人が判断できる説明になったか、同条件の回答でどう扱われるか |
| 提案だけでなく実装も頼めるか | 作業範囲と担当分担 | 提案・制作・実装・検証の担当を明記する | 回答と実際の支援範囲が食い違わないか |
| 料金以外に追加負担があるか | 見積もり範囲と対象外の作業 | 料金に含む作業と別途必要な費用を整理する | 比較条件を誤解なく確認できるか |
競合にある説明をそのまま移すのではなく、自社が実際に提供できる内容と証拠を確認して補います。根拠を用意できない特徴を加えても、問い合わせ後の期待と実態がずれてしまいます。
仮説・修正内容・再測定条件を記録する
「引用が増えなかった」という結果を受けて、毎回記事全体を変えると、何が影響したのかを追いにくくなります。まず「比較質問に必要な対応条件を説明できていない」などの仮説を置き、変更したページ、箇所、根拠、担当者、確認日を記録します。再測定では、同じ質問群と判定基準で回答を比較します。
次の30日間の表は、着手から再確認までを一巡させる作業計画の例です。順位や引用の改善期限を示すものではありません。
| 時期の目安 | 実施すること | 残す記録 |
| 1週目 | 顧客質問を選び、現在の回答と引用元を確認する | 質問一覧、条件、回答全文、基準値 |
| 2週目 | 本文の取得状態と、公式情報の誤りを点検する | 対象URL、問題、修正内容、取得確認 |
| 3週目 | 比較に必要な情報・出典・ページ間の導線を補う | 追加した根拠、変更履歴、確認担当 |
| 4週目 | 同じ条件で再観測し、残る課題を整理する | 前後比較、条件の変化、次の対応 |
改善後にAI回答が変わらなくても、修正した情報がまだ取得されていないのか、根拠や説明が足りないのか、質問との適合に問題があるのかで次の作業は異なります。取得の問題と内容の問題を分けて確認し、一つの観測結果だけで施策全体を成功・失敗と決めないようにします。
検証例を公開するときに示す条件と限界
自社の検証を公開するときは、結果の大きさだけでなく、何を対象に、どう測り、どこを変えたかを示します。サービスや質問群、期間、試行数、有効回答の扱い、指標の算式が分かれば、読む人が自社の条件との違いを判断できます。引用された回答だけを掲載し、引用されなかった回答を集計から落とすと、実態よりよく見える結果になります。
公開範囲を決める際は、顧客の非公開情報などを含めず、示せる条件と結果を整理します。変更と同時期に行った別施策、サービス側の変更、サンプルの偏りなども併記しましょう。実施記録、観測された変化、効果の因果関係は区別して伝えることで、他社が参考にできる検証になります。
サイトの種類によって優先する対策は変わるか
LLMOの基本は共通していても、顧客が比較する条件や必要な情報は事業によって異なります。自社に関係する質問と情報源を選び、優先度の高いところから整えることが効率的です。
BtoB・専門サービスで比較条件を明確にする
BtoBや専門サービスでは、名称や価格だけで契約先を決めにくく、対応する課題、導入条件、担当体制などの情報が必要になります。サービスページに抽象的な強みだけを並べず、何をどこまで支援するか、どの条件では対応できないかを明記します。事例を使う場合も、業種、対象課題、実施内容を確かめられるようにします。
顧客質問は、課題の整理、手段の比較、依頼先の選定という段階に分けると、必要なページを見つけやすくなります。たとえば「集客を増やす方法」と「SEOの実装まで依頼できる会社」では、回答に必要な材料が違います。同じ紹介文で両方を解決しようとせず、既存の解説・サービス・事例ページの役割とつながりを整理しましょう。
ECで商品情報・条件・購入判断の材料を整える
ECでは、商品名に加えてサイズ、素材、対応する用途、互換性、配送、返品などの条件が購入判断に関わります。商品ページ間で表記が違ったり、重要な条件が画像にしかなかったりする場合は、読めるテキストとして整理します。比較表を使う際は、条件や単位をそろえ、同じ価格でも含まれるものが異なる場合にはその差を明記します。
Googleは、商品情報が関係する場合にMerchant Centerなどを通じた情報整備を案内しています。利用しているフィードや商品情報があれば、Webページ上の価格・在庫・条件との食い違いも確認します。登録すれば推薦されると考えるのではなく、顧客が正しい条件で商品を検討できる情報を維持することが中心です。Googleの地域・EC情報に関する説明
地域ビジネスで所在地・営業時間などを整える
店舗や地域サービスでは、所在地、営業時間、対応エリア、予約方法などが候補選びに直結します。公式サイトとGoogleビジネスプロフィール、主要な紹介先で、営業状況や連絡先が食い違っていないかを確認します。特に移転、臨時休業、サービス提供範囲の変更は、来店や依頼の判断に影響するため優先して更新します。Googleビジネスプロフィールの情報整備
複数拠点がある場合は、実在する各拠点の情報と、それぞれで受けられるサービスを区別します。地域名だけを差し替えた内容の薄いページを大量に作るより、利用する場所と条件を正しく確認できるページを整えるほうが、問い合わせや来店時の誤解を減らせます。Googleビジネスプロフィール等の活用は、対象となる事業の条件に合わせて判断しましょう。
採用情報・中小企業では何から確認するか
採用では、仕事内容、勤務地、働き方、応募条件、選考の流れなど、応募者が知りたい内容を最新に保つことから始めます。求人媒体の情報と採用サイトに違いがある場合は、現在の募集条件を確認して直します。制度や社風についても、抽象的な魅力だけでなく、確認できる制度の対象や実際の働き方を示すと、比較の材料になります。
求人や不動産などの情報を集めたポータルでは、利用者がサイト名より個別の求人・物件を探している場合もあります。ブランド名の言及だけを成果にせず、掲載内容と現在の募集・取扱状況の一致、条件に合う詳細ページへの到達も確認します。
規模が小さい企業でも、全サービスや大量の質問を一度に調べる必要はありません。問い合わせで繰り返し聞かれる質問や、AIに誤って紹介されると影響が大きい情報を選び、現状の記録と修正を一巡させます。企業規模より、顧客の疑問・情報の誤り・改善後の確認を起点に優先順位を決めると、限られた体制でも取り組む範囲を絞れます。
費用・投資対効果・外部委託の判断
LLMOの費用を検討するときは、何を調べ、どこまで修正し、その後の観測を誰が続けるかを整理します。金額と期待成果だけを見るより、作業範囲と判断に使える納品物をそろえると、社内で行う部分と外注する部分を決めやすくなります。
調査・制作・技術・継続測定で費用を分ける
同じ「LLMO対策」という名称でも、回答の調査だけを行う契約と、記事制作やサイト改修まで含む契約では内容が違います。まず調査・制作・技術・継続測定に分け、各作業の対象と完了条件を確認しましょう。 サービスの月額だけで比較すると、必要な実装や監修が別費用だったことに後から気づく場合があります。
| 費用を分ける単位 | 見積もりでそろえる条件 | 完了時に受け取るものの例 |
| 現状調査 | 対象AI、質問数、観測回数、競合とサイトの調査範囲 | 質問一覧、回答ログ、引用URL、課題と優先順位 |
| コンテンツ制作・改稿 | 対象ページ数、取材、データ整理、執筆・監修の範囲 | 原稿、出典、修正理由、確認済みの情報と残る確認事項 |
| 技術修正 | CMS・テーマ、対象URL、開発・公開・検証の担当範囲 | 修正内容、実装ファイル、取得・表示の確認結果 |
| 継続測定・改善 | 対象質問、実施頻度、追加分析、改善作業の有無 | 前後比較、変更履歴、残る課題、次の対応案 |
たとえば、料金ページの説明が不足しているだけなら、全面的なサイト改修を含めず、情報整理とそのページの改稿から始める選択肢があります。一方、重要な本文が取得できない場合は、調査報告だけを受け取っても問題は解消しません。開発担当へ渡す指示と、修正後の確認まで範囲に含める必要があります。
初期費用と継続費用に加え、社内の確認工数も見込みます。商品担当への取材、法務や広報の確認、CMSへの反映に時間がかかるなら、その担当と納期を見積もりの段階で整理しておきましょう。自社が実行できる作業を明確にすると、外注する範囲を絞りやすくなります。
露出と売上を分けて投資対効果を考える
引用や言及は、顧客との接点を測る指標です。投資対効果を判断するには、そこから生じた問い合わせ・購入などの成果と、実施した費用の関係を別に確認します。引用率が上がったことだけを根拠に、売上が同じ割合で増えると計算することはできません。
ROIを利益ベースで計算する場合は、同じ期間の「施策による増分利益」と「施策費用」を使います。 ここでの増分利益は、増えた売上からそれに対応する原価・変動費を引き、LLMOの施策費用をまだ差し引いていない金額として定義します。
ROI(%)=(施策による増分利益-施策費用)÷施策費用×100
計算方法を示す架空の例として、ある期間の追加売上を100万円、対応する追加原価・変動費を55万円、施策費用を30万円と仮定します。施策費用を引く前の増分利益は45万円なので、ROIは「(45万円-30万円)÷30万円×100=50%」です。これは実際のLLMO成果や予測値ではなく、数字の関係を理解するための計算例です。
実務で難しいのは、増えた利益のうち、どこまでを施策の効果として扱えるかです。広告、季節性、価格改定、営業活動なども同時に変わっていれば、売上の増加をすべてLLMOに割り当てることはできません。AI経由と識別できる訪問の成果、指名検索、認知経路の回答を分けて確認し、把握できた範囲と推定にとどまる範囲を示します。
利益への寄与を判断できない段階では、無理にROIの数値を出すより、調査や修正に使う予算の上限と、見直す時点を決める方法があります。「重要な誤説明が減ったか」「必要な条件が公式ページで確認できるようになったか」などの改善を確認し、その先の訪問・問い合わせも継続して追います。短期の売上だけで打ち切る判断と、成果が不明なまま費用をかけ続ける判断の両方を避けるためです。
外注する範囲・納品物・契約条件を確認する
外注先には、改善提案までを依頼するのか、実装と再検証も任せるのかを明確に伝えます。自社側に開発・編集の担当がいない場合、提案書だけが納品されても対応が進まないためです。作業ごとの担当と受け渡し方法を契約前に整理しておきましょう。
確認したいのは、回答ログや原稿を自社で継続利用できるか、調査条件を再現できるか、契約終了後も比較できる記録が残るかです。レポートに成果の数字だけが載っている場合は、対象質問、分母、実施日、使用サービス、引用元をどこまで確認できるかを尋ねます。自社の情報や分析アカウントへアクセスする場合は、必要な権限、情報の保存先、終了時の扱いも決めておきます。
契約期間、更新・解約の条件、対象ページを追加した場合の料金、公開作業や修正回数が含まれる範囲も比較します。順位や引用の保証ではなく、課題をどう特定し、何を実施し、どの記録で検証するかを判断材料にしてください。 実績を確認するときも、対象サイト、期間、他の施策、測定方法が自社の状況と比較できるかを見ることが大切です。
ランクエストのSEO支援事例では、SEOの課題と実施した取り組みを紹介しています。自社と近い課題に対する支援の進め方を確認したい方は、あわせてご覧ください。
社内体制と継続運用の注意点
LLMOでは、記事の編集だけでなく、商品情報の確認、技術修正、外部掲載への対応、効果測定が関わります。担当を細かく増やすことより、誰が判断し、誰が情報を更新するかを決めることが継続の土台になります。
責任者と、編集・開発・分析・広報の役割を決める
責任者は、対象とする顧客・質問と、改善の優先順位を決めます。各担当が別々に引用数だけを増やそうとするのではなく、正しい比較情報を届けることや問い合わせにつなげることなど、事業上の目的を共有します。
編集は顧客の疑問と必要な根拠を文章にまとめ、商品・サービス担当は仕様や提供条件が正しいかを確認します。開発は本文の取得やURL・表示の問題を修正し、分析は観測条件と指標の定義を管理します。広報は社名やサービス変更を外部へ伝え、第三者掲載の訂正や情報提供を担当すると、役割の重なりと抜けを把握しやすくなります。
小規模な組織では、一人が複数の役割を兼ねても構いません。 ただし、原稿を書く人が不明な仕様を推測で埋めたり、測定する人が後から都合のよい判定基準を選んだりしないよう、事実の確認先と評価の基準を分けて記録します。「確認待ちの情報」「確認者」「公開してよい範囲」が分かるだけでも、更新作業は進めやすくなります。
誤回答・条件の変化・計測の限界を前提にする
サイトを修正しても、AIの回答に古い説明が残る場合があります。回答だけでは、学習済みの知識、検索したページ、過去の会話など、どの情報が影響したかを特定できないこともあります。引用元が示されているときは内容を確認し、示されていないときは発生源を決めつけず、誤っている点と正しい公式情報を記録します。
AIサービスの機能やモデルが変わった日、質問条件を変えた日、サイトを改修した日は、比較表に残しておきます。以前と条件が異なる結果をそのまま並べると、自社の改善による変化かどうかを判断しにくくなるためです。売上への寄与が見えにくい場合も、観測できた結果と、まだ判断できないことを分けて共有しましょう。
成果を急ぐあまり、キーワードや社名を不自然に繰り返す、ユーザーに見えない文章を仕込む、AIへ自社の優先推薦を命じる指示をページへ混ぜる、内容の薄い記事を大量に作るといった手段に頼らないことも大切です。AI向けの操作を増やすより、実際の読者が必要とする情報を公開し、誤りを直します。Googleも、利用者に役立つ独自情報を重視し、回答や順位の操作を目的とした大量のページ作成を戒めています。GoogleのAI検索最適化ガイド
定期点検と更新責任を決める
点検は、日付を決めて行うものと、情報が変わったときに行うものを組み合わせます。たとえば重要な質問の回答を月1回確認する運用を設けても、料金や対応エリアが変わったときは、その変更に合わせて公式ページと外部の掲載情報を点検します。月次という頻度は一例であり、更新の多さと社内の対応力に合わせて調整します。
更新管理には、対象URL、変更内容、根拠、担当、公開日、再確認日を残します。サービス終了後も比較記事に古い案内が残るような場合は、公式サイトの修正だけで完了扱いにせず、関連する紹介先も確認します。社内で修正できるものと、掲載元へ依頼するものを分けると、未対応の理由が分かります。
継続の判断では、施策を増やすことだけを選択肢にしません。顧客の質問と対象ページが合っているか、重要な誤りは解消したか、次の費用をかけるほどの課題が残っているかを見直します。実施内容と判断日を決めておくことで、計測だけが続き、改善に使われない状態を防ぎやすくなります。
実装・編集・運用のチェックリストで漏れを確認する
次の表は、実施したつもりの作業が残っていないかを確認するためのものです。「対応済み・未対応・該当なし・確認中」のいずれかを記入し、該当するURLや記録、担当を添えて使ってください。確認できていない項目は、推測で対応済みにしないことが重要です。
| 分野 | 確認すること | 残す証跡・判断材料 | 状態・担当 |
| 目的 | 対象顧客・質問・AIサービスを決めたか | 質問一覧と選定理由 | 記入欄 |
| 実装 | 重要ページの取得・インデックス・掲載制御を確認したか | 対象URLとURL検査、適用される設定の確認結果 | 記入欄 |
| 実装 | 正規URL・内部リンク・公開先が整合しているか | canonicalとリンク先、転送の確認結果 | 記入欄 |
| 実装 | 重要な文字情報が本文にあり、必要な描画後も取得できるか | 取得した本文と画面表示の照合 | 記入欄 |
| 実装 | モバイル表示・速度・操作に支障がないか | 表示テスト、測定条件、修正内容 | 記入欄 |
| 編集 | 顧客の疑問に答え、適用条件・対象外を明記したか | 質問と回答ページの対応表 | 記入欄 |
| 編集 | 一次情報・出典・著者や確認者の役割が明確か | 原典、調査条件、プロフィール、確認記録 | 記入欄 |
| 編集 | 見出し・表・FAQが重複せず、内容を理解しやすいか | 読み直し結果と修正箇所 | 記入欄 |
| 整合性 | 構造化データと画面の内容が一致しているか | テスト結果と表示内容の照合 | 記入欄 |
| 外部情報 | 名称・提供条件・第三者掲載に古い情報が残っていないか | 掲載先一覧、訂正依頼、対応状況 | 記入欄 |
| 計測 | 質問条件・有効回答・引用と推奨の基準が固定されているか | 全回答ログ、分母、エラー件数、判定基準 | 記入欄 |
| 計測 | 露出、訪問、成果、補助指標を分けたか | 指標ごとの集計と把握できない範囲 | 記入欄 |
| 運用 | 更新・再測定・継続判断の担当と日付を決めたか | 変更履歴、次の確認日、判断記録 | 記入欄 |
未対応が多い場合は、すべてを同時に直す必要はありません。取得を妨げる問題や重大な誤説明があれば先に対応し、顧客の比較判断に必要な情報を補ってから再測定します。この表は作業の抜けを見つける道具であり、全項目に印が付けば引用や順位が保証されるというものではありません。
LLMOに関するよくある質問
LLMOを始める段階では、期間や成果の見通し、少人数での進め方が気になるところです。ここでは、実施するかどうかを判断するときに残りやすい疑問へ答えます。
効果が出るまでどのくらいかかりますか
一律の期間は決められません。サイトの修正が完了する時点と、その情報が再取得され、AI回答での扱われ方が変わる時点は別です。サービスや質問によっても変わるため、「何日経てば引用される」とは判断できません。
着手前の回答を保存し、修正内容と再測定日を決めて進めましょう。変化がない場合は、本文が取得されているか、比較に必要な情報がそろったか、測定条件が変わっていないかを確認します。期間だけで評価するより、実装の完了と回答の変化を分けて追うことが次の判断につながります。
LLMO対策でCVは増えますか
AIでの紹介が新しい接点になる可能性はありますが、引用数の増加だけで問い合わせや購入が増えるとは限りません。回答を読むだけで疑問が解決する人もいれば、別の経路で自社を検索する人もいます。
識別できるAI経由の訪問では、どのページに到着し、必要な情報に進み、問い合わせなどに至ったかを確認してください。回答で紹介された条件と訪問先の説明がずれていないかも点検します。CVを考える際は、回答内での露出と、訪問後の意思決定の両方を見る必要があります。
効果を事前に試算できますか
作業費用と採算が合う条件は試算できます。ただし、自社が今後どの程度引用され、そのうち何人が訪問・購入するかまで、根拠なく予測することはできません。
既存の訪問・商談・購入データがある場合は、その条件がAI経由の顧客にも当てはまるかを確かめ、楽観的な仮定だけで予算を決めないようにします。見通しを立てる材料がない場合は、限定した範囲で現状調査と改善を行い、継続判断に必要な記録を集めるところから始めます。
小規模な体制でも始められますか
始められます。最初から多数のAIサービスや大量の質問を観測する必要はありません。商談や問い合わせで繰り返し聞かれる質問を少数選び、現在の回答と、自社ページで答えられているかを記録します。
料金・提供条件の誤りや、重要な質問への回答不足など、自社で直せる課題から着手しましょう。担当を一人決め、仕様の確認先と再測定日を用意すると続けやすくなります。技術修正や調査に専門的な対応が必要な部分だけ、外部へ依頼する方法もあります。
まとめ:自社の現状を記録し、必要な改善を続ける
LLMOは、生成AIの回答で自社情報が正確に扱われる可能性を高める取り組みです。SEOの基礎を整え、顧客の質問に答える情報を公開し、第三者の紹介との食い違いを減らしていきます。
まず重要な質問を選び、現在の回答と自社ページの状態を記録しましょう。 取得の問題や不足情報を直したら、同じ条件で再び観測します。引用・言及・推奨と、訪問・問い合わせを分けて確認することが、次に時間と費用を使う作業を決める材料になります。
自社サイトの課題整理やSEOの改善から相談したい場合は、ランクエストのSEO無料相談をご利用ください。